
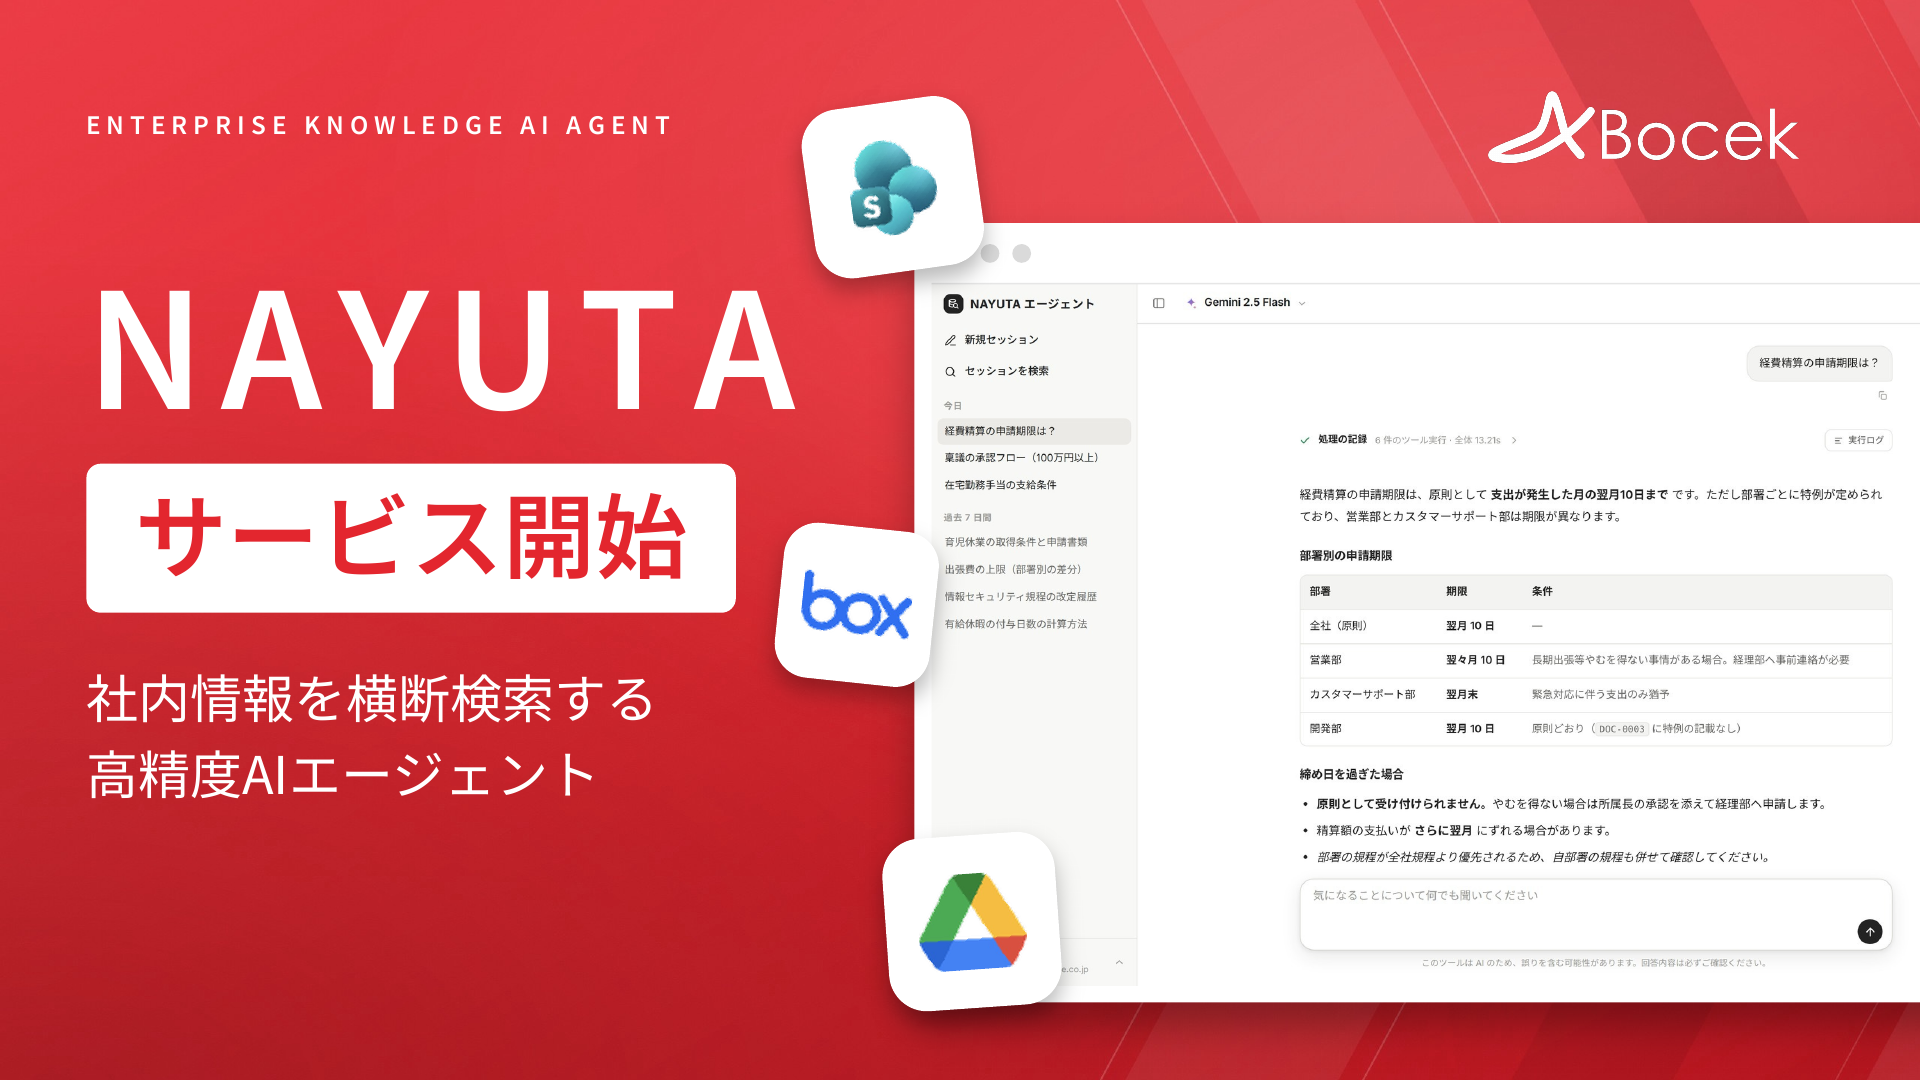
株式会社Bocek(本社:東京都港区、代表取締役社長:沖村 昂志、以下「Bocek」)は、社内の規程・マニュアル・技術資料などをAIで活用したい企業に向けて、社内情報を横断検索する高精度AIエージェント「NAYUTA(ナユタ)」の本格提供を開始しました。
「NAYUTA」は、SharePoint・Box・Googleドライブなどに散らばった社内の資料を上限なく読み込み、質問に対して、根拠となった原本とあわせて答えるAIエージェントです。資料を検索して答える一般的なAIは、読み込む資料が増えるほど回答精度が下がりやすくなります。NAYUTAは、資料が増えても精度を保てるように設計しています。大手企業の顧客データ(1万ファイル超)と当社の社内データ(10,302ファイル)を使った2つの検証で、回答精度はいずれも96%台でした。顧客データの検証では、同じ資料と同じ質問で比べた汎用AIツール(60%台)を大きく上回っています。
回答精度95%以上を出せる新技術をもとに、コンサルタントとエンジニアがデータの変換から精度の検証までを伴走します。(※回答精度は、実際の業務担当者が回答を3段階で評価する当社の評価基準で測定)
リリースの背景:社内情報のAI活用を阻む「データ」と「測り方」の課題
生成AIの普及により、多くの企業でChatGPTやMicrosoft Copilotなどの導入が進んでいます。一方で、社内の規程やマニュアル、技術資料、議事録といった「社内情報」をAIで活用しようとすると、思うような成果につながらないケースも少なくありません。
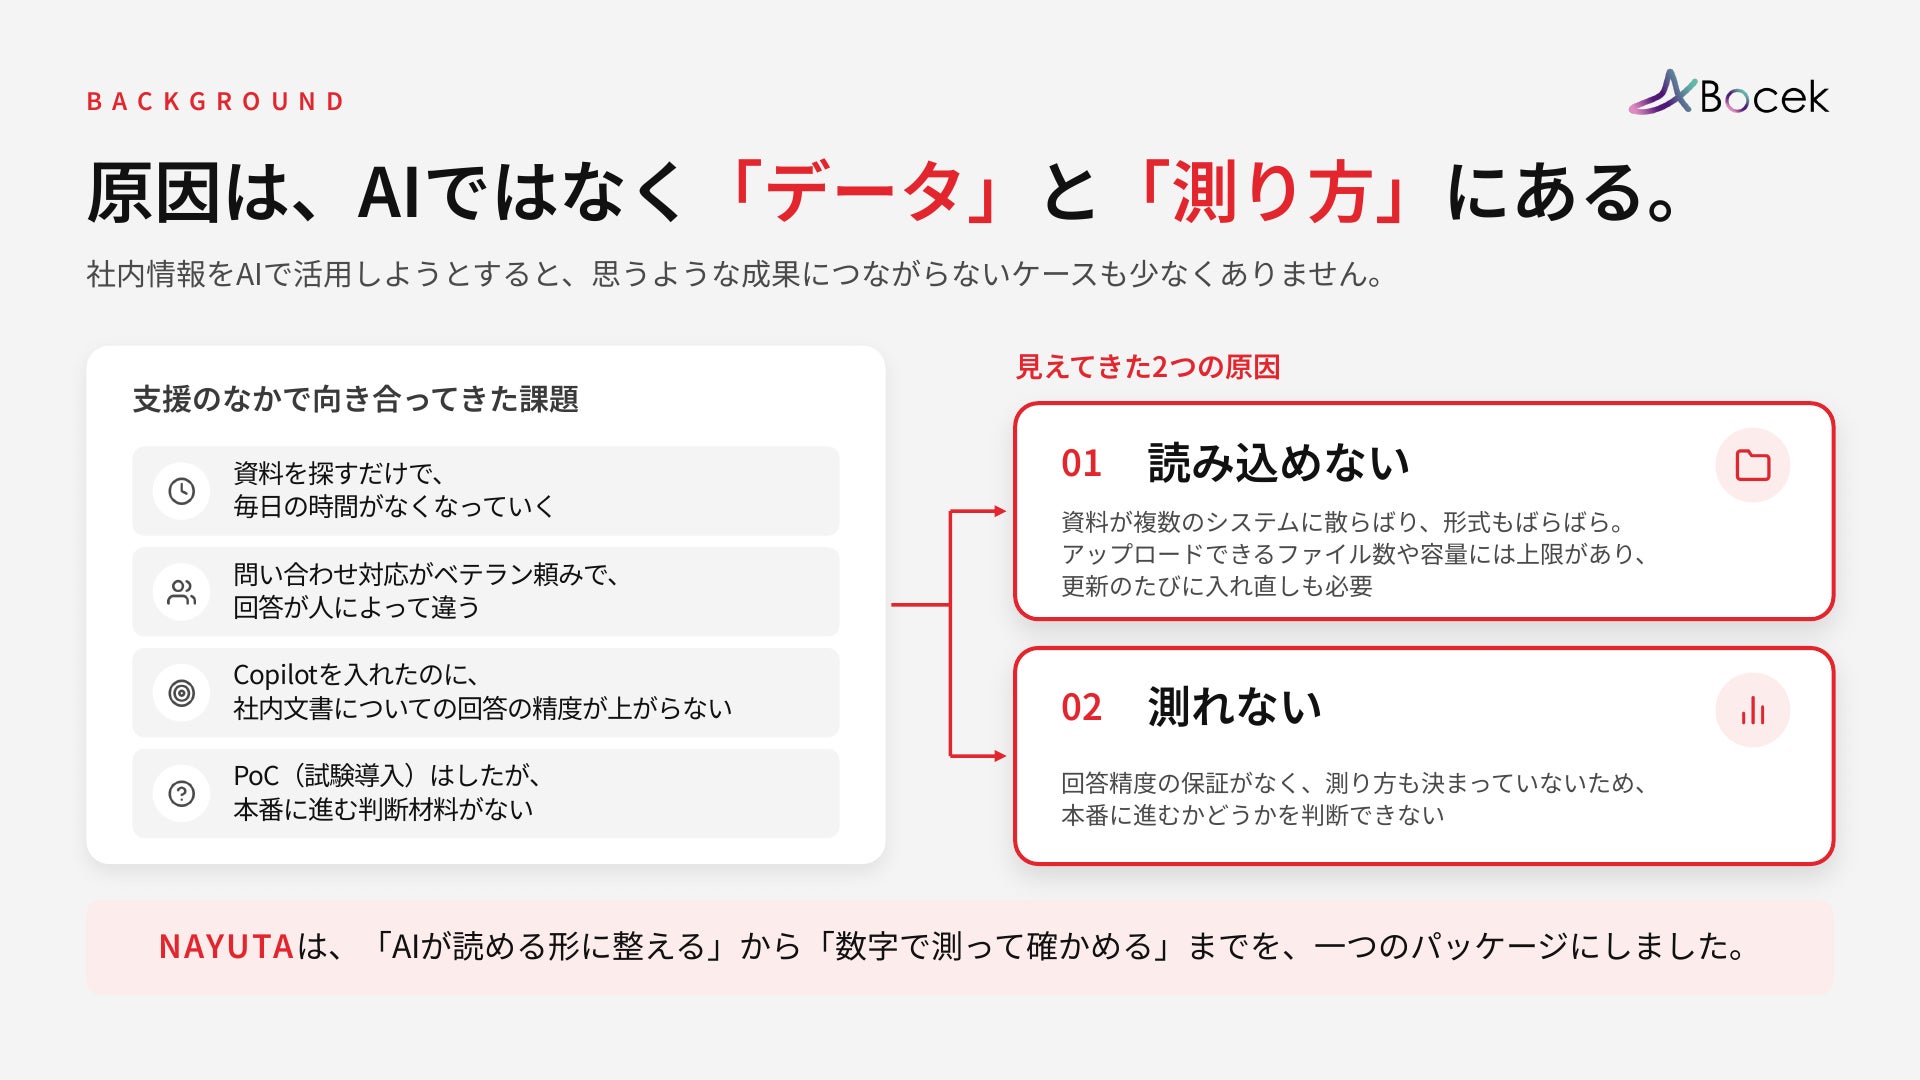
Bocekは、企業の生成AI導入やAI開発を支援するなかで、次のような課題に向き合ってきました。
- 資料を探すだけで、毎日の時間がなくなっていく
- 問い合わせ対応がベテラン頼みで、回答が人によって違う
- Copilotを入れたのに、社内文書についての回答精度が上がらない
- PoC(試験導入)はしたが、本番に進む判断材料がない
これらの課題の原因を探っていくと、多くはAIそのものではなく、AIに読ませる「データ」と、精度の「測り方」にあることが見えてきました。
① 読み込めない:資料が複数のシステムに散らばり、形式もばらばら。アップロードできるファイル数や容量には上限があり、資料が更新されるたびに入れ直しも必要になる
② 測れない:回答精度の測り方が決まっていないため、本番に進むかどうかを判断できない
そこでBocekは、データを「AIが読める形に整える」ところから、精度を「数字で測って確かめる」ところまでを1つのパッケージにした「NAYUTA」を開発しました。
「NAYUTA」概要:3つの製品と伴走支援を1つのパッケージに
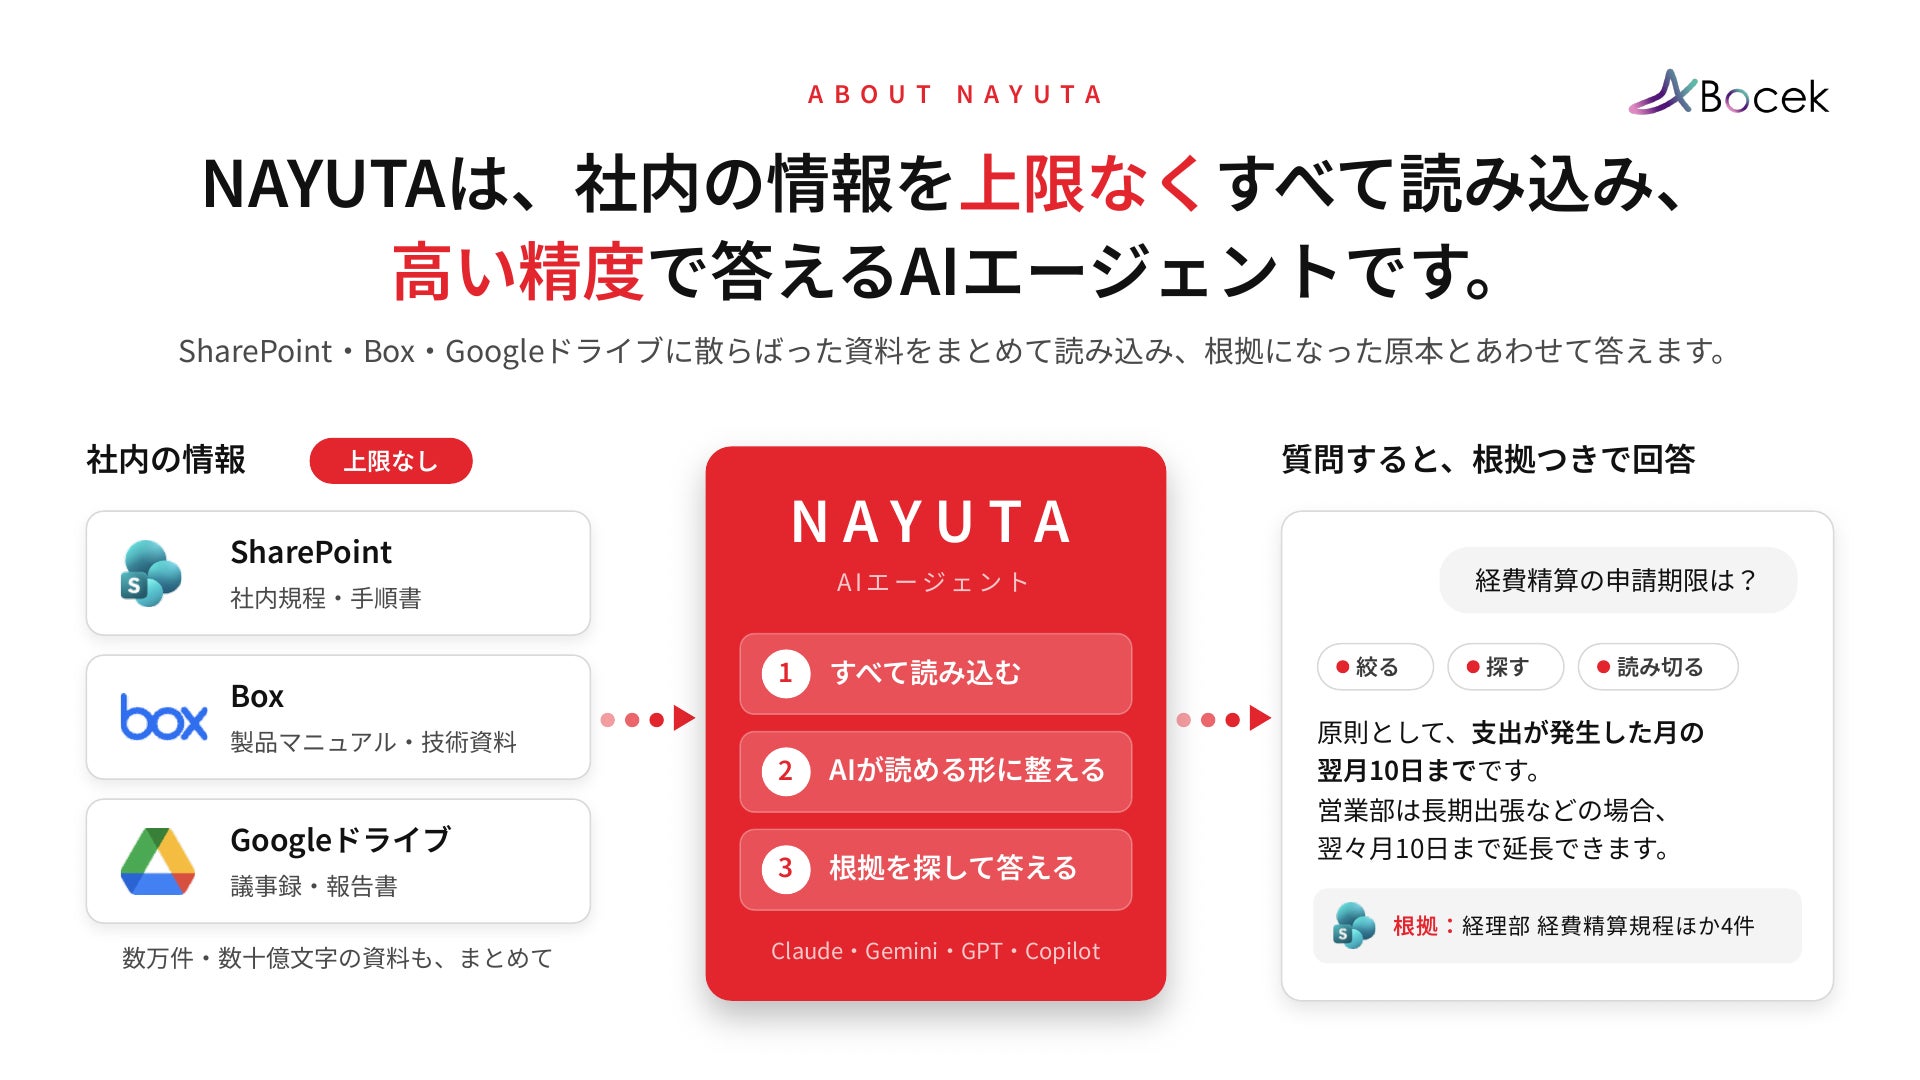
「NAYUTA」は、社内の情報を上限なくすべて読み込み、高い精度で答えるAIエージェントです。SharePoint・Box・Googleドライブに散らばった資料をまとめて読み込み、質問すると、根拠となった原本とあわせて答えます。数万件・数十億文字の資料もまとめて扱え、基幹システムとの連携やローカルLLM(社外にデータを出さず、自社の環境内で動かす生成AIモデル)にも対応します。生成AIのモデルはClaude・Gemini・GPT・Copilotから業務に合ったものを選べます。
NAYUTAは「コンサルティング+開発+ツール」のパッケージです。「つくる」「つかう」「はかる」の3つの製品で、データの変換から精度の検証までの全工程を、コンサルタントとエンジニアが伴走します。
1. つくる:NAYUTA データ変換
バラバラな資料を、AIが読める形に一括で変換します。PDF・Word・Excelを数万件まとめて変換し、文書の種類・所管部署・最終更新日などのメタデータ(文書の属性情報)を、指示文1つで自動で付与します。
2. つかう:NAYUTA エージェント
探して、読み切って、根拠つきで答えます。「絞る・探す・読み切る」の3つの探し方を使い分けて情報の取りこぼしを防ぎ、回答の根拠となった原本をその場で表示します。画面のデザインやサービス名は、オプションで自社仕様に変更できます。
3. はかる:NAYUTA アナリティクス
AIの実力を、数字で比べて選べます。精度・使いやすさ(UX)・コストを100点満点で比較し、Copilotなどの他のツールも同じ条件で評価します。
資料が増えても、精度を保つ
資料の断片を検索してAIに答えさせる一般的な仕組み(RAG)は、資料が数十件ほどならうまく動きます。一方、資料が増えると、改訂前の旧版が現行版より上位に来たり、似た文書の断片で検索結果が埋まったりして、回答に必要な箇所を拾えなくなります。
NAYUTAは、すべての資料をまとめて検索するのではなく、次の3つの探し方を使い分けて答えます。
- 絞る:文書の種類や企業名、現行版か旧版かなど、質問から確実に言える条件でメタデータを検索し、候補を確定します。
- 探す:絞り込んだ範囲の中だけで検索します。
- 読み切る:有力な文書は全文を読み、その内容だけを根拠に答えます。金額や日付は原文のまま引用します。
絞り込みに使うメタデータは、NAYUTA データ変換で資料を取り込むときに自動で付与します。
1万ファイルを超える2つの検証で、回答精度96%台
| 項目 | 顧客データ(大手企業A社) | 当社の社内データ |
|---|---|---|
| 読み込んだ資料 | 1万ファイル超(製品マニュアル、問い合わせ履歴・FAQ、対応手順書・規程など) | 10,302ファイル(議事録、商談記録、見積書・契約書・提案書、開発資料、社内規程など) |
| 評価用Q&A | 30問 | 30問 |
| NAYUTAの回答精度 | 96% | 96.7% |
| 比較 | 同じ資料と同じ質問で、汎用AIツール2種はいずれも60%台 | ― |
社内データでの検証の詳細(評価の方法、質問の内訳、誤答の分析)は、当社 取締役CTO 餌打 優太が技術記事で公開しています。
1万件超の社内文書で正答率96.7% ― RAGをやめて「絞る・探す・読み切る」にしたNAYUTAの設計(Zenn)
回答精度の測り方
NAYUTAでは、次の方法で回答精度を測っています。
- 実際の業務で想定される質問を数十問用意し、質問ごとに想定回答と根拠となる資料を決めて、評価用Q&Aをつくります。
- 同じ資料を読み込ませた各AIツールに、同じ質問を投げかけます。
- 返ってきた回答を、実際の業務担当者が「合っている(1点)」「部分的に合っている(0.5点)」「合っていない(0点)」の3段階で評価します。
- 点数の合計から、回答精度を算出します。
導入効果:調べものにかかる時間を、45分から2分に
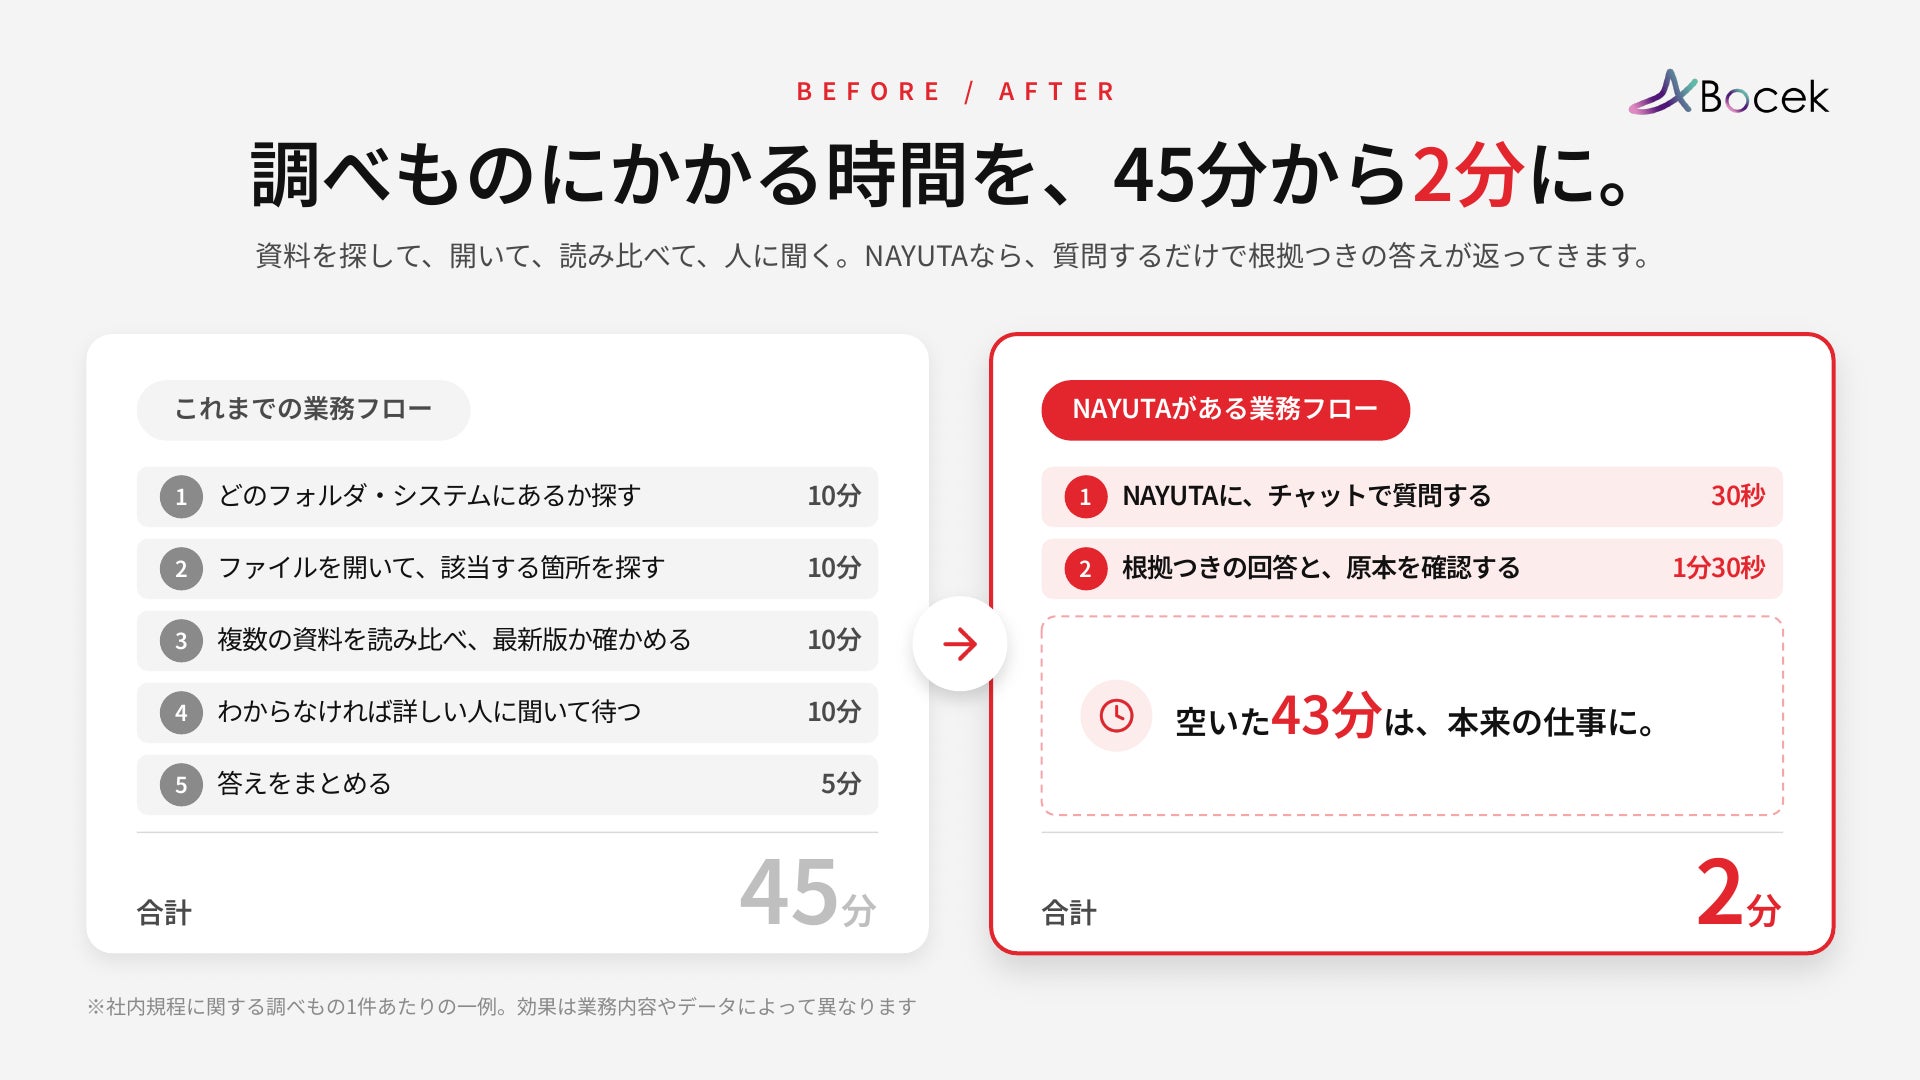
これまでは、資料がどのフォルダ・システムにあるかを探し、ファイルを開いて該当箇所を探し、複数の資料を読み比べて最新版かを確かめ、わからなければ詳しい人に聞いて待つ必要があり、調べもの1件あたり45分かかっていました。NAYUTAなら「チャットで質問し、根拠つきの回答と原本を確認する」だけで、約2分で終わります。空いた43分は、本来の仕事に使えます。
※社内規程に関する調べもの1件あたりの一例です。効果は業務内容やデータによって異なります。
事例:大手企業A社 カスタマーサポート部門(本番運用に向けて検証中)
| 項目 | 結果 |
|---|---|
| 対象の社内文書 | 1万ファイル超(PDF・Word・Excel) |
| 回答精度 | 96%(評価用Q&A 30問で測定) |
| 誤答 | 0件(評価用Q&A 30問) |
| 根拠を探す時間 | 1件あたり45分 → 2分 |
A社では導入前、1万ファイルを超える文書から回答の根拠を手作業で探していました。根拠にたどり着けるのはベテランだけで、担当者によって回答の質にばらつきがありました。
NAYUTA データ変換で文書を変換してメタデータを付与し、問い合わせ対応の業務に合わせてNAYUTA エージェントを構築。評価用Q&A 30問で汎用AIツール2種と比べながら改善を重ね、誤答0件を達成しました。検証では、回答の根拠を探す時間が1件あたり45分から2分ほどに短くなっています。現在は本番運用に向けて、現場で検証を進めています。
通常のAIエージェントとの違い

NAYUTAは、資料をアップロードして使う一般的なAIツール(以下、通常のAIエージェント)と比べて、次の4点が異なります。
- データ連携:SharePoint・Box・Googleドライブと連携し、AIが参照する情報が自動で更新されます。資料を手作業でアップロードし直す必要はありません。
- 精度:回答精度95%以上を出せる新技術を使っています。測定結果は、当社の評価基準による調査レポートとして納品します。
- 見た目・機能:画面のデザインやサービス名を自社仕様に変更でき、資料生成やTeamsのスレッドでの返信にも対応します(オプション)。
- 情報量:読み込める情報量に上限はなく、100億文字、1000億文字でも対応します。
※通常のAIエージェント=一般的な資料アップロード型AIツール(当社調べ)。精度は当社の評価基準で測定。見た目・機能の変更はオプションです。
エンタープライズのセキュリティ要件にも対応

NAYUTAは、お客様のクラウド環境内に構築し、既存の閲覧権限をそのまま引き継ぎます。データがAIの学習に使われることはありません。
| 項目 | 対応内容 |
|---|---|
| クラウド | AWS・Google Cloud・Microsoft Azure(お客様環境内・国内) |
| 生成AI | Claude・Gemini・GPT・Copilot(用途に応じて選択) |
| SSO(シングルサインオン) | Entra ID・Google Workspace・Oktaほか主要なIDに対応(SAML 2.0/OpenID Connect) |
| 権限 | 既存の閲覧権限を継承 |
| 学習利用 | 学習に使われない契約形態のみを利用 |
| 監査ログ | 質問・回答・参照した文書を記録 |
| 審査支援 | セキュリティチェックシートへの回答、要件定義書の作成 |
| 認証 | ISO/IEC 27001 認証取得 |
提供の流れと料金

回答精度95%以上を出せる新技術を、次の7つのステップで業務に合わせて導入します。設計の段階で評価用Q&Aをもとに合格ラインを決め、構築後はNAYUTA アナリティクスで測定と改善を繰り返したうえで、調査レポートとともに納品します。
- 無料相談:課題と対象データをヒアリング
- 提案:ROI(投資対効果)診断書・要件定義書・デモ環境をお渡し(ここまで無料)
- 契約:プランと期間を決定
- 設計:評価用Q&Aで合格ラインを決める
- 構築:データ変換とAIエージェントを開発
- 検証:NAYUTA アナリティクスで測定・改善
- 納品:調査レポートとともに引き渡し
| プラン | 料金の目安 | 内容 |
|---|---|---|
| 顧問プラン | 月額30万円〜 | AI活用の相談・技術選定・社内推進を伴走(開発なし) |
| 伴走開発プラン | 月額120万円 | 1つの業務で、データ変換から精度検証まで実施 |
| フルサポートプラン | 月額240万円 | 複数業務の同時推進から全社展開まで支援 |
※税抜の目安です。契約期間はサービスにより異なります。
代表コメント
株式会社Bocek 代表取締役社長 沖村 昂志
生成AIの導入は進みましたが、「社内の資料について聞いても、正しく答えてくれない」という声は今も多く聞かれます。その原因の多くは、AIそのものではなく、AIに読ませる「データ」の側にあります。NAYUTAは、データを整えるところから精度を測るところまでを1つのパッケージにし、回答精度95%以上を出せる新技術で、PoCで止まらず、現場で使い続けられるAIをお届けします。資料を探す時間が減った分、人にしかできない仕事に時間を使っていただく。AIで人の可能性を広げることが、私たちの目指すAX(AIトランスフォーメーション)です。
「NAYUTA」について
「NAYUTA」は、社内情報を横断検索する高精度AIエージェントです。SharePoint・Box・Googleドライブに散らばった資料を上限なく読み込み、資料が増えても精度を保てるように設計しています。回答には、根拠となった原本をあわせて示します。データ変換・エージェント・アナリティクスの3つの製品と、コンサルタント・エンジニアによる伴走支援をパッケージで提供します。回答精度95%以上を出せる新技術を使っています(※当社の評価基準で測定)。
株式会社Bocekについて
Bocekは、すべての企業のAI浸透・DX推進パートナーとして、ツール導入から教育・リスキリング、AI開発まで、DX推進を一気通貫で支援しています。東京科学大学発のスタートアップ(第159号)として、生成AIに特化したコンサルティング・開発事業、生成AIアプリプラットフォーム「Taskhub」の運営などを展開しています。
| 項目 | 内容 |
|---|---|
| 会社名 | 株式会社Bocek(ボセック) |
| 設立 | 2022年6月21日 |
| 代表者 | 代表取締役社長 沖村 昂志 |
| 所在地 | 〒108-0023 東京都港区芝浦3-3-6 東京科学大学キャンパス・イノベーションセンター INDEST 402 |
| メンバー数 | 45名(エンジニア25名・コンサルタント20名) |
| 事業内容 | 生成AI特化コンサルティング・開発事業/生成AIプラットフォーム運営事業/生成AI特化メディア「Taskhub マガジン」運営事業 |
| 認証 | ISO/IEC 27001 認証取得 |
| コーポレートサイト | https://bocek.co.jp/ |
| NAYUTA | https://bocek.co.jp/nayuta/ |
| Taskhub | https://taskhub.jp/ |
| お問い合わせ先 | 担当:松原/E-mail:pr@bocek.co.jp |
※記載されている会社名・製品名・サービス名は、各社の商標または登録商標です。